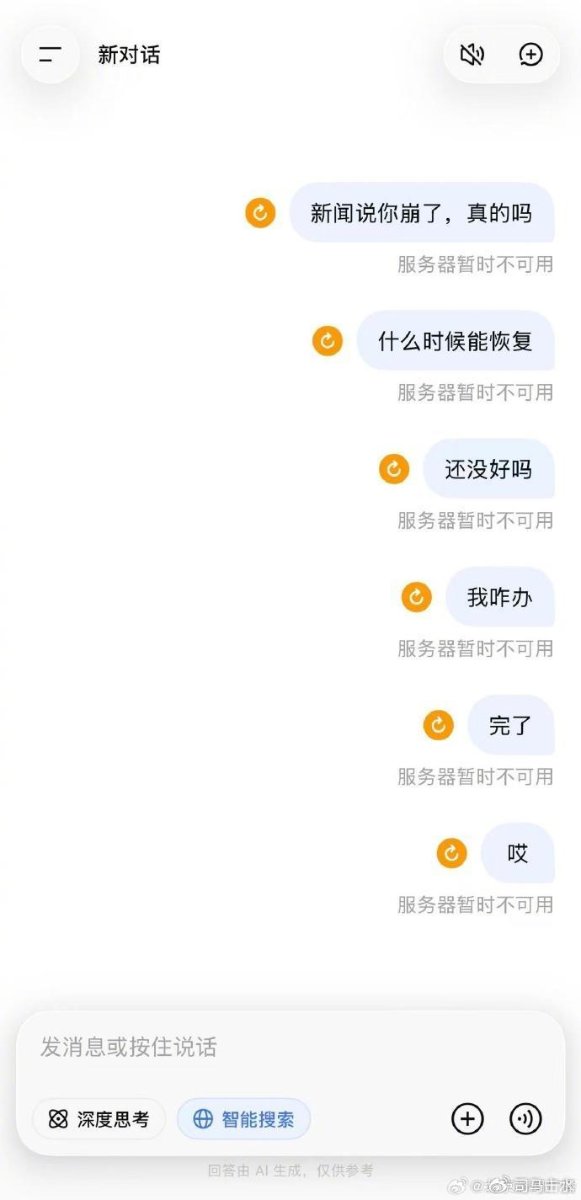
10月15日早8点过后,大量用户陆续发现DeepSeek网页端与App无法正常响应,页面反复弹出“服务器暂时不可用”的提示。截至当日上午10:30点,故障已持续超2个多小时,对话服务、DeepSeek V4.1 Flash API服务均处于部分中断状态,App端仍未完全恢复可用。DeepSeek官方回应称,目前已定位故障原因,正在实施修复,但暂未对外披露本次异常的完整技术细节。
这已经不是DeepSeek2026年第一次登上“服务异常”热搜。根据公开的用户反馈记录,今年以来平台已出现至少18次服务波动,其中5月更是出现了连续多日的服务中断,此前行业普遍将故障原因指向用户量暴涨与算力储备增长不匹配——数据显示,2026年DeepSeek用户规模同比增长66.7%,但算力储备仅增长8.3%,供需失衡直接导致高峰时段服务器承压过载。但在本次故障的社交平台讨论区里,一个此前很少被主流讨论的猜测正在快速扩散:这次DeepSeek崩溃,会不会是AI自己把服务器搞崩了?
这个猜想并非完全无迹可寻,部分行业现象早已露出端倪。不少长期使用DeepSeek的开发者都遇到过类似的异常场景:同一个简单问题,有时模型 会突然进入超长输出状态,原本几秒钟就能返回的结果,会持续生成几百上千字还不停止,后台Token消耗量是正常情况的数十倍。这类现象背后,就是大模型的生成机制出现了“循环自锁”,如果这类异常进程在短时间内批量出现,完全可能在外部流量没有明显增长的前提下,瞬间打垮整个服务集群。
更值得注意的是,DeepSeek此前公开的算力分配规则,本身就放大了这类风险:平台将超过七成的算力优先供给模型训练,留给普通用户和API调用的推理算力不足三成。在推理池本就紧绷的前提下,只要模型内部出现少量异常自激进程,就可能像多米诺骨牌一样,快速耗尽所有剩余算力,最终触发全链路的服务中断。
截至发稿,DeepSeek仍未公布本次故障的完整技术报告,“AI自己搞崩服务器”的猜想目前还没有官方信息支撑,属于社区层面的技术推演。但这个猜测能在短时间内大范围传播,本质上戳中了当下AI行业的一个普遍隐忧:我们对大模型内部的运行逻辑,远没有对传统软件那么可控。
传统软件的服务崩溃,基本都能追溯到明确的代码漏洞、流量冲击或硬件故障,所有异常路径都在开发者的预期范围内。但大模型是基于海量数据训练出来的黑箱系统,它的很多运行行为无法通过传统的单元测试完全覆盖,谁也无法保证,在某些极端输入组合下,模型不会触发某种此前从未被发现的异常机制,最终反过来拖垮支撑它运行的服务器。
从这个角度看,无论本次10月15日的故障最终原因是什么,“AI自己把服务器搞崩”的讨论,都给整个行业提了一个醒:当大模型越来越深地嵌入办公、生产的核心流程,我们不仅要补足算力的缺口,更要建立一套针对大模型自身异常行为的监测、熔断机制,避免未来真的出现AI自发引发的系统性故障。
————————————————
版权声明:本文为CSDN博主「司马击水」的原创文章,遵循CC 4.0 BY-SA版权协议,转载请附上原文出处链接及本声明。
原文链接:https://blog.csdn.net/momo163/article/details/168004880
